合成音声(MYCOEIROINK)を作って世に出してから約半年なので振り返る記事
- 半年で出した合成音声の数
- 半年で自合成音声関係で参加した企画・イベント
- 他の方に使われているのか?
- 約半年経っての反省
- 自分が想定している使用用途と周囲の使用用途がたぶん違う
- 【たぶん周囲の人が想定しているMYCOEの使い方】
- 【私が想定しているMYCOEの使い方】
- これからについて
COEIROINKで使える合成音声「木下にび」を出したのが10月3日。
4月3日で半年経つのでびっくりしています。
※CoeFontでも合成音声を2021年に出してはいるが
自分で使っていないのでここではカウントしていない。
【MYCOEIROINK】勢いで合成音声を8キャラクター作ってみた感想その2
【はじめに】
前回の記事では合成音声8キャラにわけると管理大変~💦
おすすめできない~💦って話をしました。
【MYCOEIROINK】勢いで合成音声を8キャラクター作ってみた感想
今回は録音のときの所感をかきます。
【声の使い分けについて】
声の使い分けができているかはわからないのですが
だいたい声の高低で3パターン、喉か鼻に力を入れる、ウィスパー風に喋らせるで
8パターン作っているので私レベルならそんなに難しくはないと思います。
もともと声活動を始めたジャンルが
一人で全キャラ演じるという今考えると狂気のジャンルで
中にはバケモノみたいに演じ分けする人とかいました。声帯複数飼ってるのか?
そこでつながった方たちに自作MMD動画にも出てもらっている方もいるのですが、
「この声しか出ない」っていう人がいなくて、
ちょっとした説明で演じ分けをしていただけるのでめちゃくちゃ依頼しやすいです。
食べ物を依頼しても戸惑うだけでちゃんと演じていただけるのでありがたいなと思います。
食べ物を役として依頼するな。
これが声を依頼した人みんな戸惑ったって
あとで聞いて申し訳ないなあと思った動画です。
ニコニコのトップにも晒されました。ニコニコ運営のチョイスがおかしいな?
【何が難しいか】
声の使い分け自体は難しくはないですが、
前回の記事で「前録音したときのキャラの声が思い出せない」
っていうのに加えてもう1点問題があります。
一人で演じるとして、だいたいメインのキャラクターでも
動画30分で台詞数50、しかも「あっ」とか「おい」とか短めの台詞もあるから
数の割にそこまで読む文字数少ないです。
私が投稿しているMMDのショートドラマでも
2分~5分程度で800文字~1500文字程度なので
多くてメインキャラで20台詞あればいいほう。
それに対して、今私が合成音声モデルを生成しているMYCOEIROINKは
ITAコーパス・MANAコーパスあわせて652文読む必要があります。
※10文からでも学習はできる。ただしフル録音時に比べて発音が不明瞭になる。
中には2~3行ぐらいになりそうな長文を途中で噛まずに読まないといけません。
40文~50文なら聞き直しもしやすいので、
声が違うなってファイルをいくつかリテイクするだけなのですが
652文もあれば100文あたりから声が維持できなくなります。
なんだったら最初と最後で声が違って笑えません。
後から652文全部確認はきついので、都度都度声が違ったらリテイクする方式を今はとってます。
COEIROINKさんは優秀なので、
多少の声の高低に違いがあっても合成音声モデル生成時に
ある程度の差は吸収はしてくれるのですが
それでも限度がありまして。
最初に作った音声を聞いていただけると
だいぶ破綻しているのがお分かりいただけると思います。
当時はITAコーパス424文収録する必要があったんですが、
そこまで長時間録音したことがなかったので
少年声を出そうとしたら普通に最後あたりの台詞が
地声に近くなったという悲しい思い出があります。
こんにちはをちゃんと発音できないかわいそうな合成音声。
のーまる改である程度アクセント改良されたので
あいさつ文や疑問文が入っているMANAコーパスには感謝しています。
【合成音声と関係ない話】
今は非公開にしているので見られないのですが、
ニコニコ動画に投稿して今日で1●周年らしくて
月日が経つのがはやすぎてウソだろ……ってなってます。
うそだろ……
【MYCOEIROINK】勢いで合成音声を8キャラクター作ってみた感想
【はじめに】
CoeFontだけでなく、TALQuやCOEIROINKなど
ここ2、3年で自分で合成音声を作成し、
配布したり、ほかの方に使用してもらえたりする状況になってきました。
UTAU化に挫折した経験のある私としては
「えっ、文章読み上げればできるんですか!?(要編集・学習)」
ということでCOEIROINK向けにいっぱい作った結果、
キャラクターとしては8人(個別に割り振るの面倒くさかったので名前は一緒)
現時点で12スタイルほどあります。
※なぜCOEIROINKを選択したのかは2022-10-13の記事参照
【8キャラクター作ってみた感想を簡潔に書くと】
・単純に多くて管理しきれない
・スタイル追加が五月雨式になる
・前録音したときのキャラの声が思い出せない
端的にいうと
_人人人人人人人人人_
> おすすめしない <
 ̄Y^Y^Y^Y^Y^Y^Y^Y^Y^ ̄
【詳しく書くと】
・単純に多くて管理しきれない
もともとキャラクターとしてのイメージがないところ、
今ようやくバストアップのイラストを追加していっている状態で
現在5/8が終わりました。
キャラ数として多いと1キャラクターに
かけられる時間が少なくなってしまうのでおすすめできません。
8人いるうちの何人か優先的にスタイルや立ち絵を追加するのも手ですが
合成音声「木下にび」の最終の利用用途を考えるとそれができないので
自分で首を絞めていくスタイルです。
・スタイル追加が五月雨式になる
スタイル追加をローテーションさせているので
1キャラクターあたりスタイル追加が
3か月程度かかっています。
1キャラクター向けに3スタイルほどまとめて追加しようとすると
ITAコーパス+MANAコーパスフル録音と、
GoogleColabでの学習をお金出して早めたとしても
頑張って1スタイル追加に1週間~2週間はかかるので、
後回しになったキャラクターのスタイル追加がえらく遅れるという。
「5スタイル新たに追加しました!」という告知もしにくいです。
なんせ別々のキャラクターだし……。
・前録音したときのキャラの声が思い出せない
どんな声も一定で出すことができればよいのですが、
プロでもないのでだいたい前回収録時の声が思い出せなかったり、
声が変わっていたりします。
そのためコーパス文を録音し、学習までまわしてみて
「通常バージョンと比べると声が違うやん」とやり直し、
ということを何回かすることになります。実際何回かしてます。
とくにITAコーパス+MANAコーパス全部収録後、
時間と場合によってはお金もかかるGoogleColab上での
学習をある程度進めた状態でこうなると泣くことになります。
声として安定感があるだけでなく、
キャラ毎に声の使い分けしているプロはすごいですわ。
【個人で管理できる限界だと思われるキャラクター数】
「とりあえずスタイルは後で追加するかも
しれないけど作ってみよう、立ち絵も用意しておくかな」
であれば5キャラ
「気合を入れてキャラクターを作成した、
これから順次スタイルを追加していく予定」
というのであれば3キャラクターぐらいが限界じゃないかなって気はします。
とはいえ「うちの合成音声8人いるんですよ~」といったら
だいたい初見の人は驚くので一発ネタとしては秀逸だと思います。
ずいぶん手間のかかる一発ネタですね。
【8人いる自合成音声 木下にびについて】
そんな自合成音声である木下にびですが、
「8人もいるとかどんな音声だよ」と興味がありましたら
下記のサイトからサンプル視聴できます。
COEIROINKの製作者であるシロワニさんが
何故かWebサイト上にユーザー追加音源までまとめてくださっているため、
こちらでも視聴できます。
8キャラクターもいる一番の問題はシロワニさんの
リソースをくっていることな気がします。
ニコニコ大百科などでCOEIROINKの記事をたまに編集しているので許してほしい。
動画投稿しました COEIROINK向けの合成音声追加のお知らせです
COEIROINKで使える合成音声「木下にび」の新しい音源が増えたので告知動画出してきました。2022年のニコニコ動画投稿はこれで最後です。
【10月に投稿した告知動画以降に追加されたの】
- 木下にび<プロトタイプ> のーまる改
- 木下にび<女性01> のーまる改
- 木下にび<裏声> のーまる
- 木下にび<少年01> のーまる
- 木下にび<曖昧> のーまる
- 木下にび<少年02> のーまる
だいたいのキャラクターは1キャラクターに対して感情スタイルを増やす、声が違うなら別キャラクター(双子や兄弟など)を作成していくのが主ですが、私は名前つけるのが面倒くさいから男性だろうが中性だろうが女性だろうが無性だろうが全部木下にびで統一しています。
使う人が困惑するかもしれないけど自分以外たぶん使わないので無問題。キャラクターとして分けてはいますが、若干声がかぶっているのもありますね。652文を同じ声で読み上げるのが難しくてだんだん収録していくうちに声が変わるからです。
もし全種類使うのであれば同じ名前なのを有効活用してもらえると面白いかもしれませんね。違う世界線の同一人物とか、多重人格とか。
木下にびのラストに追加する声は決めているのですが、次に収録する予定の女性02の声が決まらないので追加音声は少し遅れると思います。
MYCOEIROINK配布兼忘備録用にWEBサイトも11月上旬から作りました。Googleサイト、広告も出ないしパパっと作るには便利ですね。
動画投稿しました その2 <MMDとCOEIROINK>
台本ができたのが12日夕方⇒MMD廃の投稿期間が13日22時まで⇒
RTAやったら動画作れんじゃない!?ということで投稿しました。
COEIROINKなら突発的に声入り動画を作ろうと思ってできるんだ。
今回お借りした音声は
- 【店員】つくよみちゃん さん(さんを付けていいのか迷いますが)
- 【弁当】松嘩りすく さん
- 【お客】おふとんP さん
です。客に当てる声を黒聡鵜月さんと迷ったのですが、
どちらかというと声質的にイメージが近かったのでおふとんPさんを選定しました。
主にあせりスタイルを使って若干気弱な感じを出しています。
COEIROINKの音源、男性キャラクターで10スタイル以上のキャラクターが
確認できるだけでも3人はいるの何気にすごいですよね。
松嘩りすく さんは絶叫を使うだけで笑ってしまうので卑怯だと思います。
話声スタイルがイケボなので決め台詞(?)もある弁当を担当してもらいました。
女性キャラクターはMYCOEIROINKと迷ったのですが、
スタイル数が「げんき」「おしとやか」「れいせい」の3つある
つくよみちゃんをお借りしました。
叫んでいる部分についてはげんき、
普通に呼びかけている部分はれいせいスタイルを利用しています。
今回初めてMMD動画にソフトウェアトークを利用するという試みをしましたが、
ドラマ系動画製作者にとってはスタイル数が足りないと
声の選定段階で候補から外れてしまうことも多いので
下記3スタイルはあると嬉しいかなというのが率直な感想であり、
個人的な発見だったなあと思います。
- 普通の喋り
- ある程度声をはりあげているスタイル(叫び/怒り)
- 弱っている感じのスタイル(悲しい/あせり)
にびーず(私の声のMYCOEIROINK)も声の種類ではなくてスタイル増やすか……?
でも無秩序に声を増やしたい。
動画投稿しました その1 <COEIROINK / ユーザーモデル応援祭向け>
ユーザーモデル応援祭向けに、
作成したMYCOEIROINK 木下にび<裏声>の宣伝?も兼ねて動画投稿してみました。
内容としてはブログの前の記事に書いた
「Google Colabratoryを使わずともMYCOEIROINKはできるのかチャレンジした」
内容となっています。サムネ・ガ・ネタバレ。
作成していて思ったことといえば、自合成音声使うときにお借りした立ち絵だと
過激なことを言いにくいので専用の立ち絵が欲しいなって思いました。
※今回、立ち絵として瑠璃蝶さん制作のものをお借りしました。
ありがとうございます。
一応キャラクターデザインはあるにはあるのですが、
イラストが悲しいぐらい描けないんですよね。
(画力は下の画像参照)
依頼しようにも配布するとなると条件が条件なので有償でも頼みにくいので
私が絵をかけるようになるか、描いてくださる天使のような方が出てこないと
永遠に立ち絵が実装されないと思います。
そもそも立ち絵が実装されても使われるのかという話はここでは置いておきます。
ご自身で声収録して絵もご自身で描いている方すごいですよね。
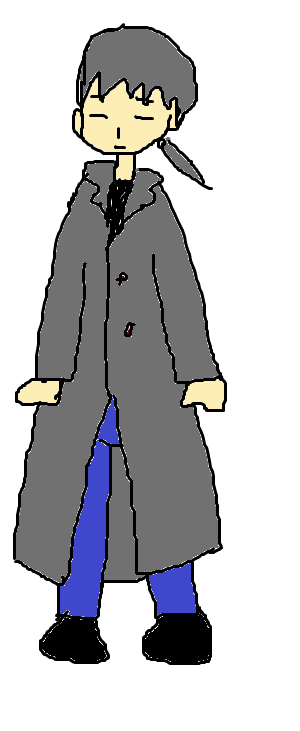
これはプロトタイプをイメージしたやつ
MYCOEIROINKを自PCでも生成できるか検証してみた
最近Google Colabratoryの無料制限がきつくなってきたので
タイトルの通りのことを試してみました。
なんちゃってコーダーしていた人が適当に動かした結果なので間違い等あるかも。
■結果
生成はできたが、ところどころ声がおかしくなって使い物にならない。
たぶんGPUの性能が足りないせいなので、
おとなしくGoogle Colabratoryを使った方がいい。
※VRAM12GB以上あることを前提にしているので。
有料版を利用をしたとしても、
他のGPUが使えるクラウドサービスと比較して
Google Colabratoryは結構安いはず。
■検証環境
OS:Windows11 Home
CPU:Intel(R) Core(TM) i7-9700 CPU @ 3.00GHz
メモリ:16.0 GB
GPU:NVIDIA GeForce GTX 1650
Ubuntu on Windows : Ubuntu 20.04.5 LTS
Python3.8
※たぶんLinuxでもできると思う。
MacはNVIDIA製のGPUを搭載していないので厳しい
■必要な知識
・Python・pip3
・Git(要GitHubアカウント)
・Linuxコマンド
■参考にならない手順
※試行錯誤したらいつの間にかできていたので抜けがあるかもしれない。
1. Linux用Windowsサブシステムの有効化(していないのであれば)
2. WSL2をインストール(していないのであれば)
「wsl --list --verbose」でバージョン確認。
Version1の場合は2に切り替え。
3. Ubuntu上にNVIDIA ドライバーをインストール(していないのであれば)
このあたりの記事が参考になるかも。
WSL 2上のUbuntuでNVIDIAのGPUを有効にする方法
https://qiita.com/ryohassay/items/15fab8a72847be13d16d
Ubuntu上で「nvidia-smi」コマンドでDriver Version等が出るようになればOK。
4. Ubuntu上にPythonインストール(していないのであれば)
MYCOEIROINK生成コードでは3.7だが、3.8でも一応動作した。
とはいえバージョンは合わせておいたほうがよさげ。
5. MYCOEIROINK生成コードを頼りにPythonライブラリを落としてくる
MYCOEIROINK作成コード_ベータ版にあるソースコードを見て
必要なPythonライブラリを落としてくる。
「import ***」ってなっているやつをひたすらpip3 install
6. MYCOEIROINK生成コードを頼りにGitからソースコードを落としてくる
「https://github.com/shirowanisan/espnet.git」
「https://github.com/kaldi-asr/kaldi」
この2つをGitHubからひっぱってきたうえで
事前学習モデルもしくは自身のモデルをフォルダに格納する
7. MYCOEIROINK生成コードのソースコードを参考にPythonでソースコードを書く
Googleドライブのマウントや
音声数の確認といった部分は省いてもOK。
また、フォルダの構成が異なっているので変更が必要。
8. 録音音声ファイルの格納
今回は自分の音声で実施。
用意できないのであれば、
ITAコーパス音声を配布している方のをお借りするなど手がある。
※音声を借りた場合、生成したものは絶対配布しないこと
9. シェルの実行
メモリーが足りないといわれたら
「finetune.yaml」のbatch_bins・num_workersの数を小さくしてやる。
■注意
今回できるかどうか試してみしただけで、
推奨できる方法ではないので注意。
また、製作者であるシロワニさん氏からは
「COEIROINK提供の事前学習モデルもしくは
自身で作成したモデル以外で学習したものをMYCOEIROINKとして配布は禁止」
とあるので、配布を前提に自PCで生成する際は注意。
※そもそも自PCで配布できるものを生成するのは難しそうな気はする
■所感や余談
・実行中はGPUの熱がやばくなる
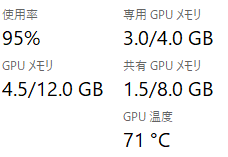
・Google Colabratoryと同様の環境を用意しようとすると
グラボだけでも30万はかかる。
個人的にはがっつり使用するわけでなければお金払った方が良いと思う
